Usar InferNode desde OpenCode
OpenCode es un agente de código que corre en la terminal: lee tu repositorio, propone cambios y ejecuta comandos. Acepta cualquier proveedor compatible con la API de OpenAI, así que puede usar los modelos de InferNode con tu llave, en tu máquina o dentro de un notebook del laboratorio.
Todo lo que OpenCode necesita cabe en un archivo de configuración y una variable de entorno. La llave nunca se escribe en el archivo.
Antes de empezar
- Una llave de InferNode (
sk-saptiva-…). Si no la tienes, pídela a tu administrador o consulta Administrar tu llave. - La URL base de InferNode de tu instalación. Termina en
/infernode/v1, no en/v1. - OpenCode instalado. Sin permisos de administrador basta con:
curl -fsSL https://opencode.ai/install | bash
opencode --version
El instalador deja el binario en ~/.opencode/bin; si la terminal no lo encuentra, agrega esa carpeta al PATH.
1. Guarda la llave en una variable de entorno
Crea un archivo que solo tú puedas leer y cárgalo en cada terminal nueva:
mkdir -p ~/.config/opencode
printf 'export INFERNODE_API_KEY="%s"\n' 'sk-saptiva-TU-LLAVE' > ~/.config/opencode/infernode.env
chmod 600 ~/.config/opencode/infernode.env
echo '[ -f ~/.config/opencode/infernode.env ] && . ~/.config/opencode/infernode.env' >> ~/.bashrc
source ~/.config/opencode/infernode.env
Si usas zsh, cambia ~/.bashrc por ~/.zshrc. Comprueba que la llave quedó cargada y que InferNode la acepta:
curl -s https://api.<tu-dominio>/infernode/v1/me -H "Authorization: Bearer $INFERNODE_API_KEY"
Debe devolver tu usuario y tu organización. Un 401 con identity.invalid_token casi siempre significa que la variable está vacía en esa terminal; vuelve a hacer source.
2. Escribe la configuración
OpenCode lee ~/.config/opencode/opencode.json. Este archivo declara a InferNode como proveedor y registra los modelos que quieres ver en el selector:
{
  "$schema": "https://opencode.ai/config.json",
  "model": "infernode/cortex",
  "small_model": "infernode/turbo",
  "provider": {
    "infernode": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "InferNode",
      "options": {
        "baseURL": "https://api.<tu-dominio>/infernode/v1",
        "apiKey": "{env:INFERNODE_API_KEY}",
        "headerTimeout": 600000,
        "chunkTimeout": 600000
      },
      "models": {
        "cortex": {
          "id": "Saptiva Cortex",
          "name": "Saptiva Cortex (razonamiento y código)",
          "reasoning": true,
          "tool_call": true,
          "attachment": true,
          "temperature": true,
          "limit": { "context": 131072, "input": 74000, "output": 8192 },
          "cost": { "input": 0, "output": 0 }
        },
        "turbo": {
          "id": "Saptiva Turbo",
          "name": "Saptiva Turbo (rápido)",
          "reasoning": true,
          "tool_call": true,
          "attachment": true,
          "temperature": true,
          "limit": { "context": 262144, "input": 200000, "output": 8192 },
          "cost": { "input": 0, "output": 0 }
        },
        "omni": {
          "id": "Saptiva Omni",
          "name": "Saptiva Omni (herramientas y documentos)",
          "reasoning": true,
          "tool_call": true,
          "attachment": true,
          "temperature": true,
          "limit": { "context": 131072, "input": 74000, "output": 8192 },
          "cost": { "input": 0, "output": 0 }
        }
      }
    }
  }
}
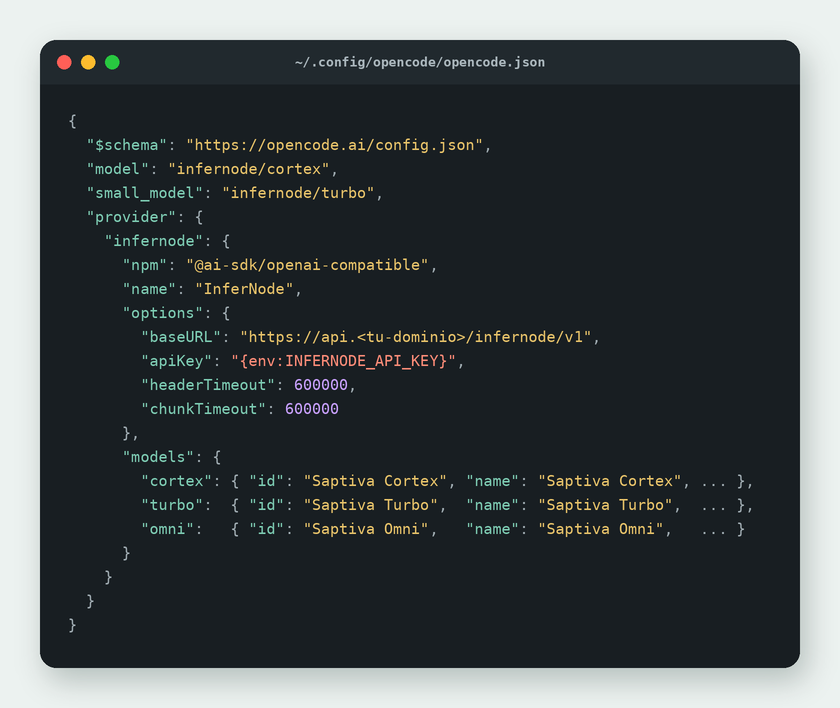
Qué hace cada parte:
| Campo | Para qué sirve |
|---|---|
npm: "@ai-sdk/openai-compatible" | El adaptador genérico para APIs compatibles con OpenAI. OpenCode lo descarga solo la primera vez que arranca. |
options.baseURL | La URL base de InferNode, con el sufijo /infernode/v1. |
options.apiKey: "{env:INFERNODE_API_KEY}" | Toma la llave de la variable de entorno al arrancar. El archivo se puede compartir sin exponer nada. |
headerTimeout, chunkTimeout | Diez minutos en milisegundos. Los modelos con razonamiento tardan en emitir el primer token; con el valor por defecto OpenCode corta la petición antes. |
models.<alias>.id | El nombre con el que InferNode conoce al modelo. Pon el alias público (Saptiva Cortex): así la configuración te sigue sirviendo cuando el modelo de atrás se actualice. El nombre del Catálogo (Qwen3.6 35B A3B (FP8), con espacios y paréntesis) solo si necesitas esa versión concreta (Elegir modelo: usa el alias). |
models.<alias> (la clave) | El nombre corto con el que tú lo llamas en OpenCode: infernode/cortex. Sin espacios. |
limit.context, limit.input, limit.output | Los tres gobiernan cuánto cabe en una sesión y cuándo OpenCode resume el historial. No son cosméticos y los valores del Catálogo no sirven tal cual: ver Elegir los límites. |
cost | En cero: el consumo se mide en InferNode, no en OpenCode. |
model, small_model | El modelo principal y el que OpenCode usa para tareas pequeñas (títulos de sesión, resúmenes). Poner el rápido en small_model ahorra tokens. |
Son tres de los cinco alias de fábrica. Los otros dos no se configuran aquí: Saptiva Embed genera vectores y Saptiva Guard modera, y OpenCode no los usa como modelo de conversación. GET /v1/models/aliases devuelve los de tu instalación, que pueden ser otros.
Elegir los límites
Dos reglas del nodo y una de OpenCode explican los números del ejemplo.
La ventana del modelo se reparte entre la pregunta y la respuesta. El context_window del Catálogo no es un tope de entrada: es el total del prompt más el max_tokens que pidas. Un modelo de 131 072 con max_tokens: 32000 acepta como máximo 99 072 tokens de prompt, y pedir max_tokens: 131072 falla siempre, incluso con un prompt de cuatro tokens.
Una petición no dura más de unos cinco minutos. Pasado ese tiempo InferNode devuelve 504 con provider_timeout (InferNode no responde). Un modelo de razonamiento emite del orden de 46 tokens por segundo, así que pedirle 16 000 tokens de respuesta agota el tiempo antes de terminar. Con 8 192 la generación tarda unos tres minutos y cabe con margen (Rendimiento medido).
OpenCode nunca pide más de 32 000 tokens de respuesta. Manda el menor entre tu limit.output y 32 000, así que declarar 131 072 no cambia lo que sale por la red.
De ahí sale el efecto que más molesta: si limit.input no está declarado, OpenCode resume el historial cuando la sesión llega a limit.context menos ese max_tokens, que es justo el punto en el que el nodo empieza a rechazar la petición. Declarar limit.input mueve el resumen hacia abajo y deja sitio para que el propio resumen quepa.
| Campo | Cómo elegirlo |
|---|---|
context | El context_window del modelo, tal cual. OpenCode lo usa para el porcentaje de contexto que muestra en la barra. |
input | El prompt máximo que aceptas. Déjalo unos 40 000 tokens por debajo de context menos output, para que quepan el resumen y un par de lecturas de archivo grandes. |
output | 8 192. Entra en el tiempo de la petición y sobra para un turno de trabajo. |
Con los valores del ejemplo, Saptiva Cortex resume el historial alrededor de los 66 000 tokens y el nodo acepta prompts de hasta 122 880. La diferencia entre esos dos números es el margen de seguridad.
GET /v1/models/{name} devuelve context_window y max_output_tokens del modelo. El primero es el total a repartir; el segundo es el tope del modelo con un prompt mínimo, no lo que vas a poder pedir en una sesión larga.
Resumen de la configuración recomendada
El archivo de arriba ya trae estos valores. Esta es la lista de lo que conviene revisar cuando cambien los modelos del Catálogo.
| Ajuste | Valor | Por qué |
|---|---|---|
model | El modelo de razonamiento y código | Es el que sostiene una sesión de trabajo con herramientas. |
small_model | El modelo rápido | OpenCode lo usa para títulos y resúmenes; entrega tokens cuatro veces más rápido. |
limit.context | El context_window del modelo | Alimenta el porcentaje de contexto de la barra. |
limit.input | Unos 40 000 tokens por debajo de context menos output | Adelanta el resumen del historial y evita topar con la ventana. |
limit.output | 8192 | Cabe en el tiempo máximo de una petición. Subirlo más no cambia nada por encima de 32 000. |
headerTimeout, chunkTimeout | 600000 | Diez minutos. Los modelos que razonan tardan en emitir el primer token. |
cost | En cero | El consumo se mide en InferNode. |
Y una costumbre que ahorra sesiones perdidas: no pidas "lee todos los archivos" sobre una carpeta de archivos grandes. El modelo pide varias lecturas en el mismo turno y el contexto puede rebasar la ventana de golpe (Contexto excedido).
3. Comprueba que OpenCode los ve
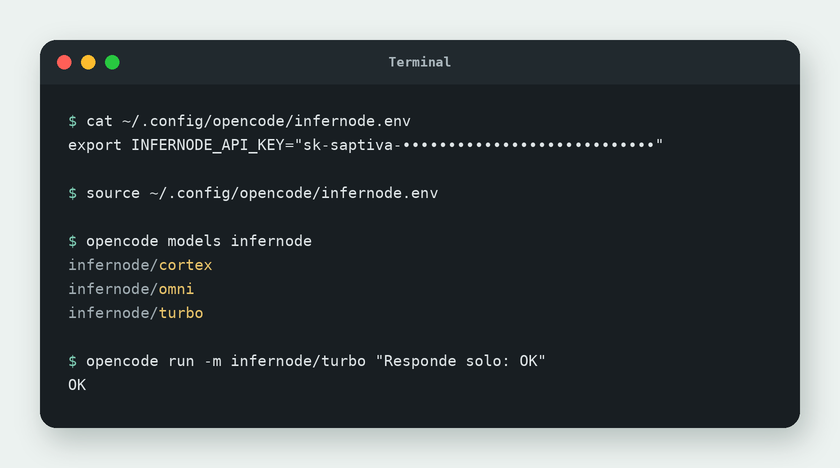
opencode models infernode
Debe listar infernode/cortex, infernode/omni e infernode/turbo. Los tres nombres cortos y la prueba de abajo se comprobaron con OpenCode 1.18 contra InferNode. Esa lista sale del archivo, no de la red: confirma que la configuración es válida, no que la llave funcione. Para eso, una petición corta:
opencode run -m infernode/turbo "Responde solo: OK"
Dentro de la interfaz interactiva (opencode a secas), el modelo se cambia con /models; ahí aparecen con el name que pusiste en la configuración.
Qué modelo usar en OpenCode
| Tarea | Modelo | Por qué |
|---|---|---|
| Programar, refactorizar, depurar | infernode/cortex | Es el modelo de razonamiento profundo y código. |
| Preguntas rápidas, renombrar, explicar un archivo | infernode/turbo | Responde en segundos y tiene el contexto más largo. |
| Tareas de varios pasos con herramientas y documentos | infernode/omni | El modelo principal de los agentes de Studio. |
Errores frecuentes
| Síntoma | Causa | Solución |
|---|---|---|
401 o "Unauthorized" al primer mensaje | La variable no está cargada en esa terminal. | source ~/.config/opencode/infernode.env o abre una terminal nueva. Verifica con el curl a /me de arriba. |
model_not_found | El id no coincide con lo que InferNode conoce. | Copia el alias o el nombre exacto de GET /v1/models, con espacios y paréntesis. El nombre con barra (Qwen/…) no funciona. |
| La respuesta llega vacía o se corta | El modelo gastó el max_tokens en razonar y no le quedó para el texto (finish_reason: length). | Sube limit.output hasta 8 192 o usa infernode/turbo. Por encima de 32 000 no tiene efecto: OpenCode nunca pide más. El razonamiento viaja en el campo reasoning de la respuesta; ver Controlar el razonamiento. |
| OpenCode termina sin escribir nada y sin error | InferNode devolvió 504 con provider_timeout: el modelo no respondió a tiempo o no está disponible en ese momento. OpenCode no muestra el error. | Confírmalo con el curl de la página API desde código con el mismo modelo: si también da 504, cambia de modelo (infernode/turbo) y reporta el request_id a tu administrador (InferNode no responde). |
400 con "maximum context length" | El prompt más el max_tokens no caben en la ventana del modelo, que se reparte entre los dos. | Baja limit.output y declara limit.input (Contexto excedido). |
| La sesión se queda muda a media tarea y no vuelve | Un turno leyó varios archivos grandes y el contexto rebasó la ventana. OpenCode reintenta en silencio, sin mensaje ni registro. | Ciérrala con Ctrl+C. Pide los archivos de a uno o usa grep (Contexto excedido). |
| Una segunda sesión de OpenCode se queda esperando | Dos sesiones a la vez sobre la misma carpeta personal se bloquean entre sí. | Espera a que termine la primera. |
| OpenCode corta la petición tras unos segundos | Timeout por defecto con un modelo que piensa antes de escribir. | Mantén headerTimeout y chunkTimeout en 600000. |
| Al reiniciar el notebook del laboratorio se perdió todo | Solo persiste tu carpeta personal. | Por eso la configuración, la llave y el binario viven en el home. Repite el source si abriste una terminal nueva. |
La misma variable INFERNODE_API_KEY sirve para el SDK de OpenAI, para curl y para OpenCode. Si rotas la llave, actualiza solo el archivo infernode.env.